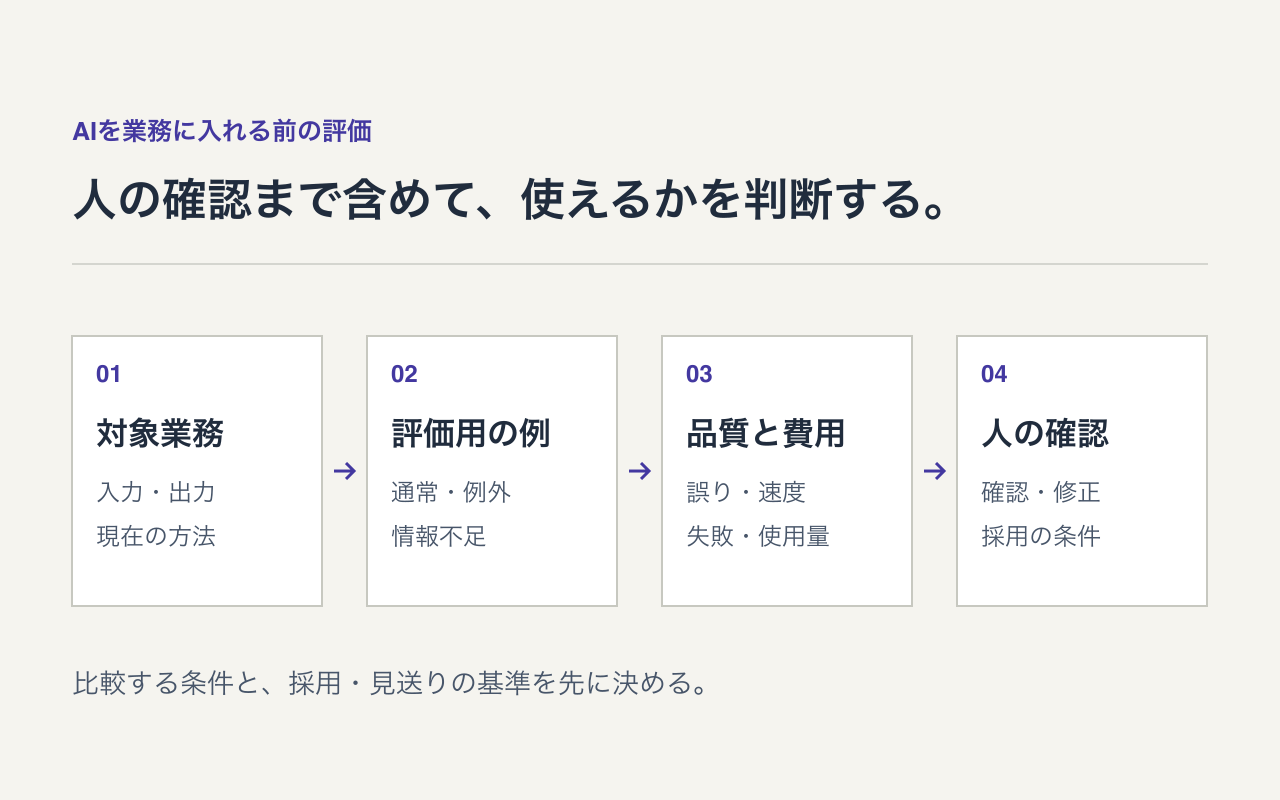
業務にAIを入れるかは、回答の正しさだけでなく、誤りを見つけて直す仕事まで含めて判断します。 評価する対象と例を先に決め、現在の方法と同じ条件で、品質・処理時間・失敗・費用を比べます。
試作が一度うまく答えても、資料が足りないとき、入力が違うとき、判断を保留すべきときに同じように使えるとは限りません。この記事では、実案件と結び付かない説明用の架空例から、導入前に合意しておきたい評価方法を整理します。
最初に、一つの業務と人の担当を決める
「社内でAIを使う」では、何を評価するかが決まりません。「問い合わせの記録を読み、担当区分の候補を出す」「資料の参照元を示して回答案をつくる」のように、入力、出力、出力を使う人を決めます。
対外送信や業務上の承認までAIに任せるのか、候補を出して人が確定するのかによって、誤りの影響は変わります。次の項目を一枚にまとめると、試作の範囲を決めやすくなります。
| 決める項目 | 説明用の例 |
|---|---|
| 対象の仕事 | 問い合わせ記録の担当区分を分類する |
| 入力 | 利用を許可された問い合わせ記録 |
| 出力 | 担当区分の候補、理由、判断保留の状態 |
| 人の担当 | 候補を確認し、担当と対応を確定する |
| 比較する方法 | 現在の手作業と、規則による分類 |
| 困る誤り | 判断が必要な記録を、確認せず処理できる記録として扱う |
決まった条件の照合や計算で解決できるなら、通常のプログラムや既存ツールも比較に含めます。AIを採用する前に、基準となる記録や項目、更新手順を整える必要がある場合は、業務とデータを整理するIT化・DX支援の考え方が役立ちます。
通常・例外・情報不足の評価例を用意する
評価する例には、期待する出力や判断の根拠を付けます。正解を一つに決められない文章では、満たすべき条件を定めます。例えば要約なら、「決定事項を落とさない」「記録にない決定を追加しない」「参照元へ戻れる」といった確認項目です。
通常の記録だけでなく、複数の担当に関係する記録、情報が欠けている記録、参照資料が古い記録も含めます。現場で生じる構成に近い例と、件数が少なくても見逃したくない例を分けて記録します。難しい例を多く集めた評価の正解率を、そのまま実運用全体の正解率と解釈しないためです。
調整に使った例と、最後に確認する例も分けます。同じ例を見ながら設定を直し、その同じ例で高い点を取っても、別の入力で使えることまでは確かめられません。
評価用の情報は、利用できる権限、送信先、保存・学習利用の条件を確認して用意します。説明用に公開する場合は、実データを加工するのではなく、最初から独立した架空例を作ります。
正解率と、誤りの影響を分けて見る
次は、同じ102件の例を使った評価結果の読み方を説明するために作った架空の表です。実際のモデルや当社の導入実績を示す数値ではありません。
| 確認項目 | 候補A | 候補B |
|---|---|---|
| 判定できた例の正解 | 92 / 100件 | 89 / 101件 |
| 必須の確認を見逃した件数 | 3件 | 0件 |
| 応答を得られなかった件数 | 2件 | 1件 |
| 入力した例の総数 | 102件 | 102件 |
候補Aは判定できた例の正解率が高くても、必須の確認を見逃しています。この誤りを許容できない仕事なら、Aをそのまま採用する理由にはなりません。Bにも誤りがあり、全件を人が確認するのか、誤りが起きやすい条件を対象外にするのかを検討します。
表では、応答を得られなかった例を正解率の分母から分けて表示しています。全入力に対する正解の割合も併記するなら、Aは92 / 102、Bは89 / 102です。分母と失敗の扱いを決めずに「精度92%」だけを比較すると、判断を誤ります。
分類なら誤分類の組合せ、回答なら参照元と内容の対応を確認します。全体平均に加えて、重要な例外や情報不足の場面を別に見ることが必要です。データ分析の比較条件も、AI評価に共通する論点です。
人が確認・修正する時間を含めて比べる
処理時間が短くても、出力を読む、参照元を開く、誤りを直す作業が増えれば、業務全体の負担は減らないことがあります。比較する作業の開始・終了をそろえ、次を分けて記録します。
- 入力を準備する時間。
- AIの処理を待つ時間。
- 人が確認・修正する時間。
- 失敗時に、元の方法へ戻して処理する時間。
待ち時間と人の作業時間は、並行して仕事を進められるかによって意味が異なります。平均だけでなく、遅い応答の分布も確認し、業務で待てる範囲を判断します。
費用は、APIの推定利用料だけで終わらせません。評価・実装の費用、入力や参照資料の整備、運用・再評価、人の確認に必要な作業を分けます。APIの単価とモデルは変わり得るため、評価日、モデル識別子、設定、使用量、計算に用いた単価を残します。
採用・対象の限定・見送りの条件を先に決める
結果を見てから都合のよい基準を作らないように、何を満たせば導入するかを試作前に合意します。例えば「必須確認の見逃しを許容しない」「回答に参照元がない場合は判断を保留する」「確認・修正を含む作業負担を現在の方法と比べる」といった条件です。具体的な数値は、その仕事の影響と現在の状態から決めます。
条件を満たさないときにも選択肢があります。用途を狭める、出力を下書きに限定する、資料を整備して再評価する、通常のシステム処理へ戻す。どこまでAIを使い、どこを人が担当するかを決めることが、試作の成果になります。
導入後は、資料・設定・モデルの変更時に再評価する例、問題の記録方法、利用を止める条件、確認する担当を運用手順に残します。
公開ツールで、評価条件と結果を残す
改善計画は、同じ正解付きデータセットで精度・速度・失敗率・推定費用を比較する基盤として、ai-decision-bench(新しいタブで開きます)を開発・公開しています。設定、データ、出力、集計方法を確認するための道具です。
模擬応答による動作確認は、実際のモデルの性能評価ではありません。また、このツールだけで人の確認時間や業務への効果を測れるわけではありません。業務上の評価表と組み合わせ、どの条件で何を測ったかを説明できる状態にします。
対象業務の整理、試作、評価、システムへの組込み、利用・運用ルールまでの支援内容は、中小企業のAI活用・導入支援をご覧ください。使う場面が決まっていない段階から、ご相談いただけます。